


Anthropic 的 Claude Code 團隊在 claude.dev 部落格公開了他們怎麼看「驗證」。這個團隊約 90% 的程式碼由 Claude 撰寫與審查,在這個規模下,讓 agent 拿出證據證明自己真的做完了,成了整條工作線最重要的一環。台灣大數據的工作分兩條線:一條是 GEO,讓品牌出現在 AI 的回答與引用裡;一條是系統開發。兩條線的日常工作都會用到 AI agent。我們讀完這篇的判斷是:一個團隊能放心交出去多少工作,要看它的驗證層撐不撐得住。
一、驗證迴圈撐得住,才放得了手
驗證迴圈撐得住多少,團隊就能同時放手多少個 agent。原文講得很直接:沒有驗證迴圈,每件事都得自己檢查,一次只跑得動一兩個 Claude;有了它,可以平行跑幾十到幾百個。Anthropic 內部在結構化檔案生成的測試裡,另設一個評分者依評分標準檢查 Claude 的產出,任務成功率比標準提示迴圈最多高出 10 分,題目越難,進步越多。
我們的看法是,驗證過去常被省略,主要是因為貴。現在測試、benchmark、規格都可以請 agent 產生,產生之後當成軟體反覆執行,不必再多花太多 token。成本結構變了,「沒時間寫測試」這個理由也跟著失效。驗證的結果還能回頭改善 agent:同一種錯反覆出現,就把它寫成 hook 或 CLAUDE.md 裡更明確的規則,讓下一次不再犯。
二、測試要挑 agent 騙不過去的那幾種
一套測試值不值得投資,要看 agent 能不能騙過它。原文推薦三種。只能選一種就選端對端測試:它走真實的使用者流程,整個功能要嘛能用、要嘛不能用,壞在哪一步也看得到。單元測試比較快、也比較穩定,但可能全數通過,功能照樣壞掉。
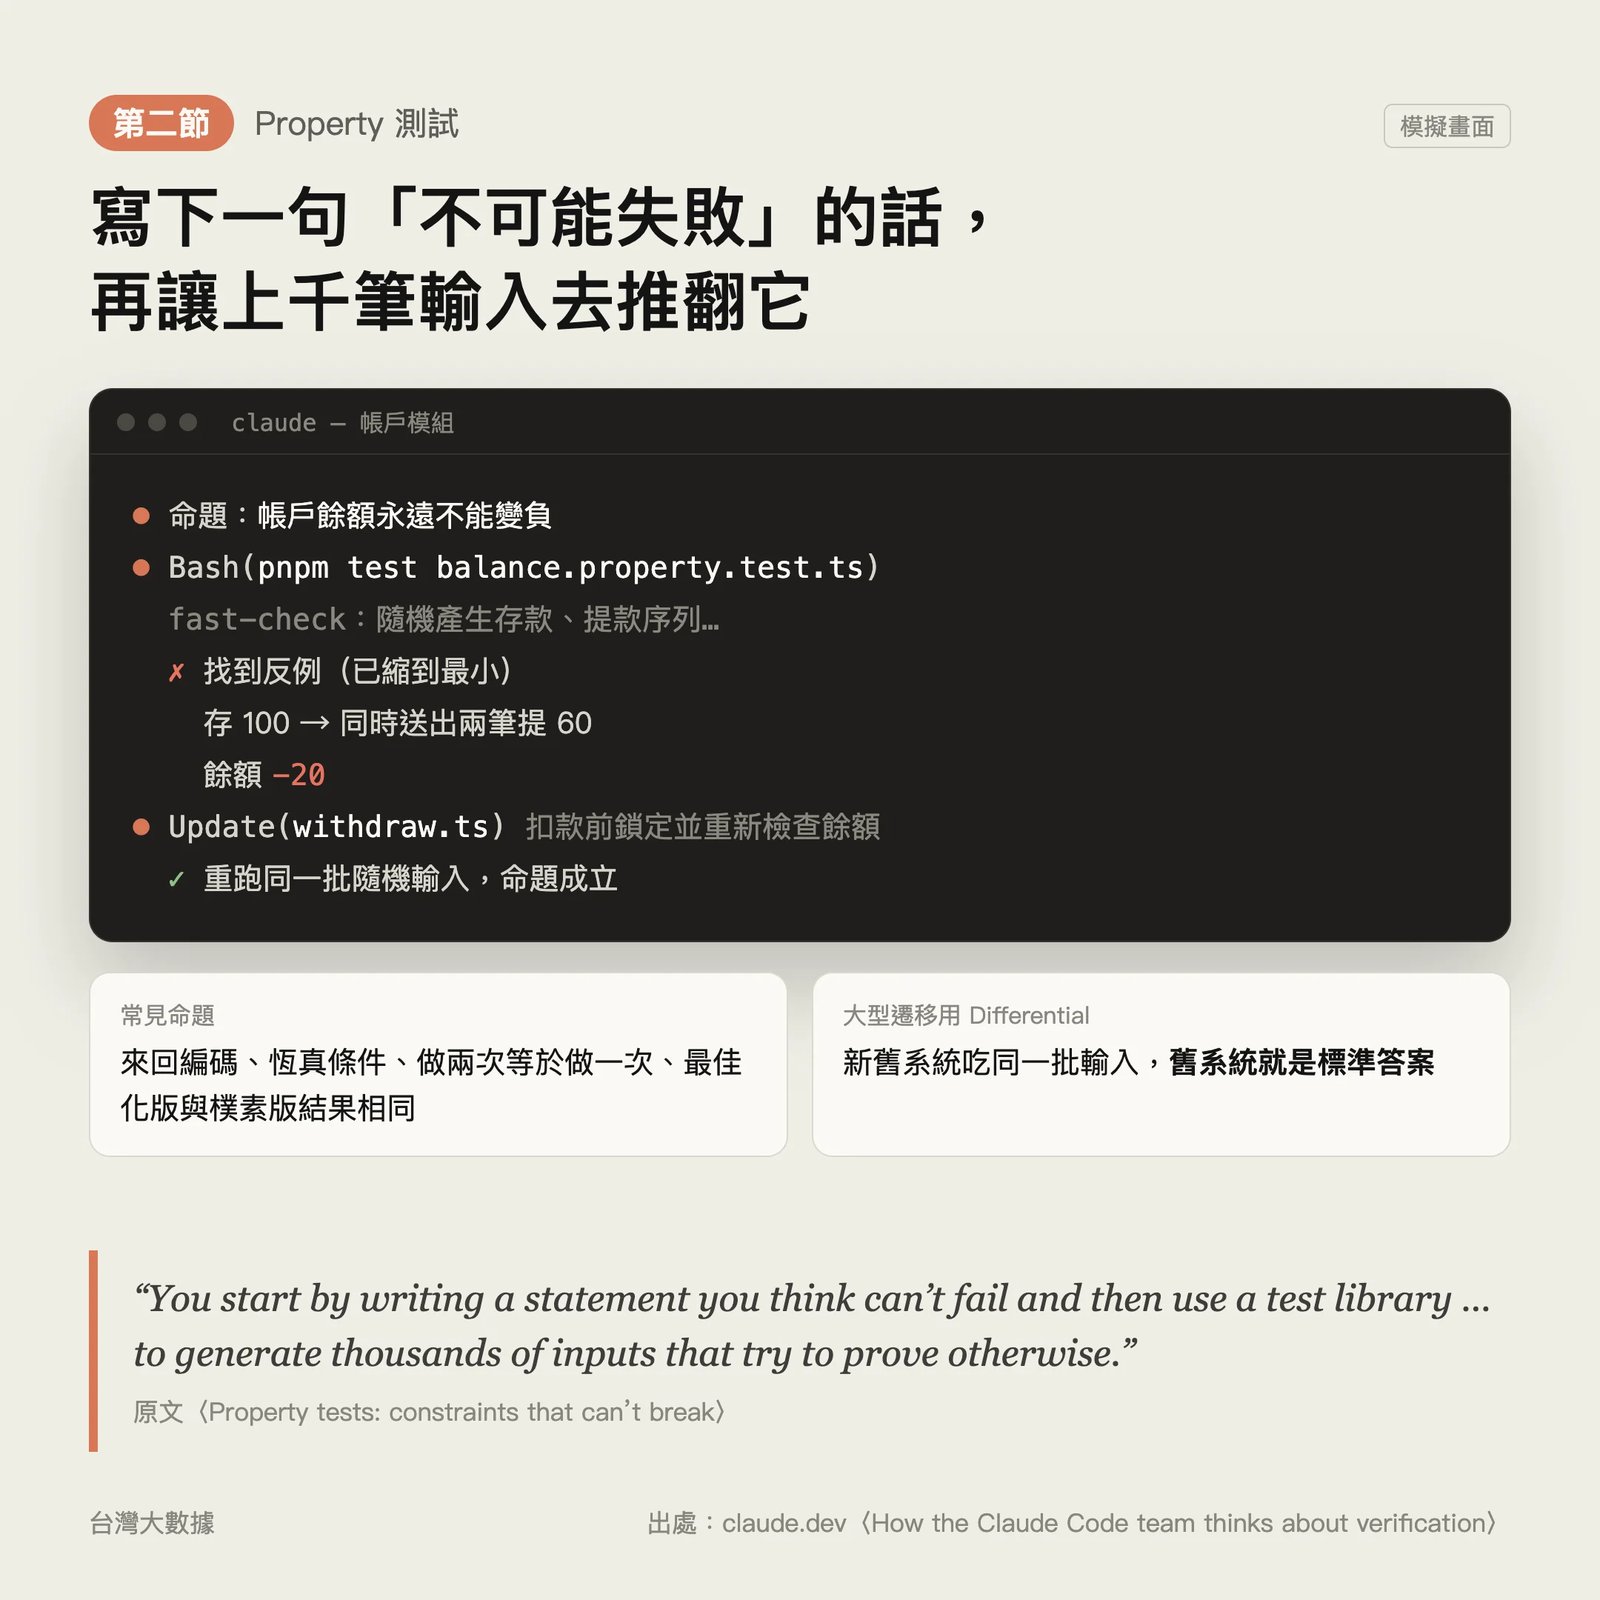
Property 測試先寫一句你認為不可能失敗的命題,例如「帳戶餘額永遠不能變負」,再用 fast-check、Hypothesis、proptest 這類工具產生上千筆輸入去推翻它。這些邊界輸入跟寫程式的 agent 沒有同一種偏誤,所以抓得到 agent 自己想不到的洞。Differential 測試適合大型遷移:新舊系統吃同一批輸入,舊系統就是標準答案,結果一有差異,就代表有 bug 或破壞性變更要處理。

我們最在意的是原文點出的失敗模式:測試不穩定,agent 會學到「再跑一次」,失敗的程式碼就沒人修;測試太慢,agent 跑得少,問題也難定位。交給 agent 的工作越多,測試穩不穩定就越重要,因為 agent 會照著測試給它的回饋學習。
三、驗證就是把改動真的跑起來
把整個應用程式端對端跑一遍,比測試更重要。網頁改動請 Claude 用 Chrome 擴充功能去點,手機用 iOS 或 Android MCP,桌面用 computer use,後端就在本機把服務跑起來。Claude Code 團隊在 repo 的 .claude/skills/ 放一個叫 verify 的 skill,寫清楚怎麼啟動與冒煙測試,Claude 在 commit 前會用它;這個 skill 本身也要反覆打磨,直到又快又穩。
人看不完每一個改動,所以團隊用失敗來決定哪裡需要人:檢查失敗由 Claude 自己修,連續三輪還是失敗,Claude 停手找人。便宜的檢查要先跑,Claude 在開 pull request 之前先跑測試、build 與 linter,免得共用的審查與 CI 時間拿去抓本來自己就抓得到的錯。

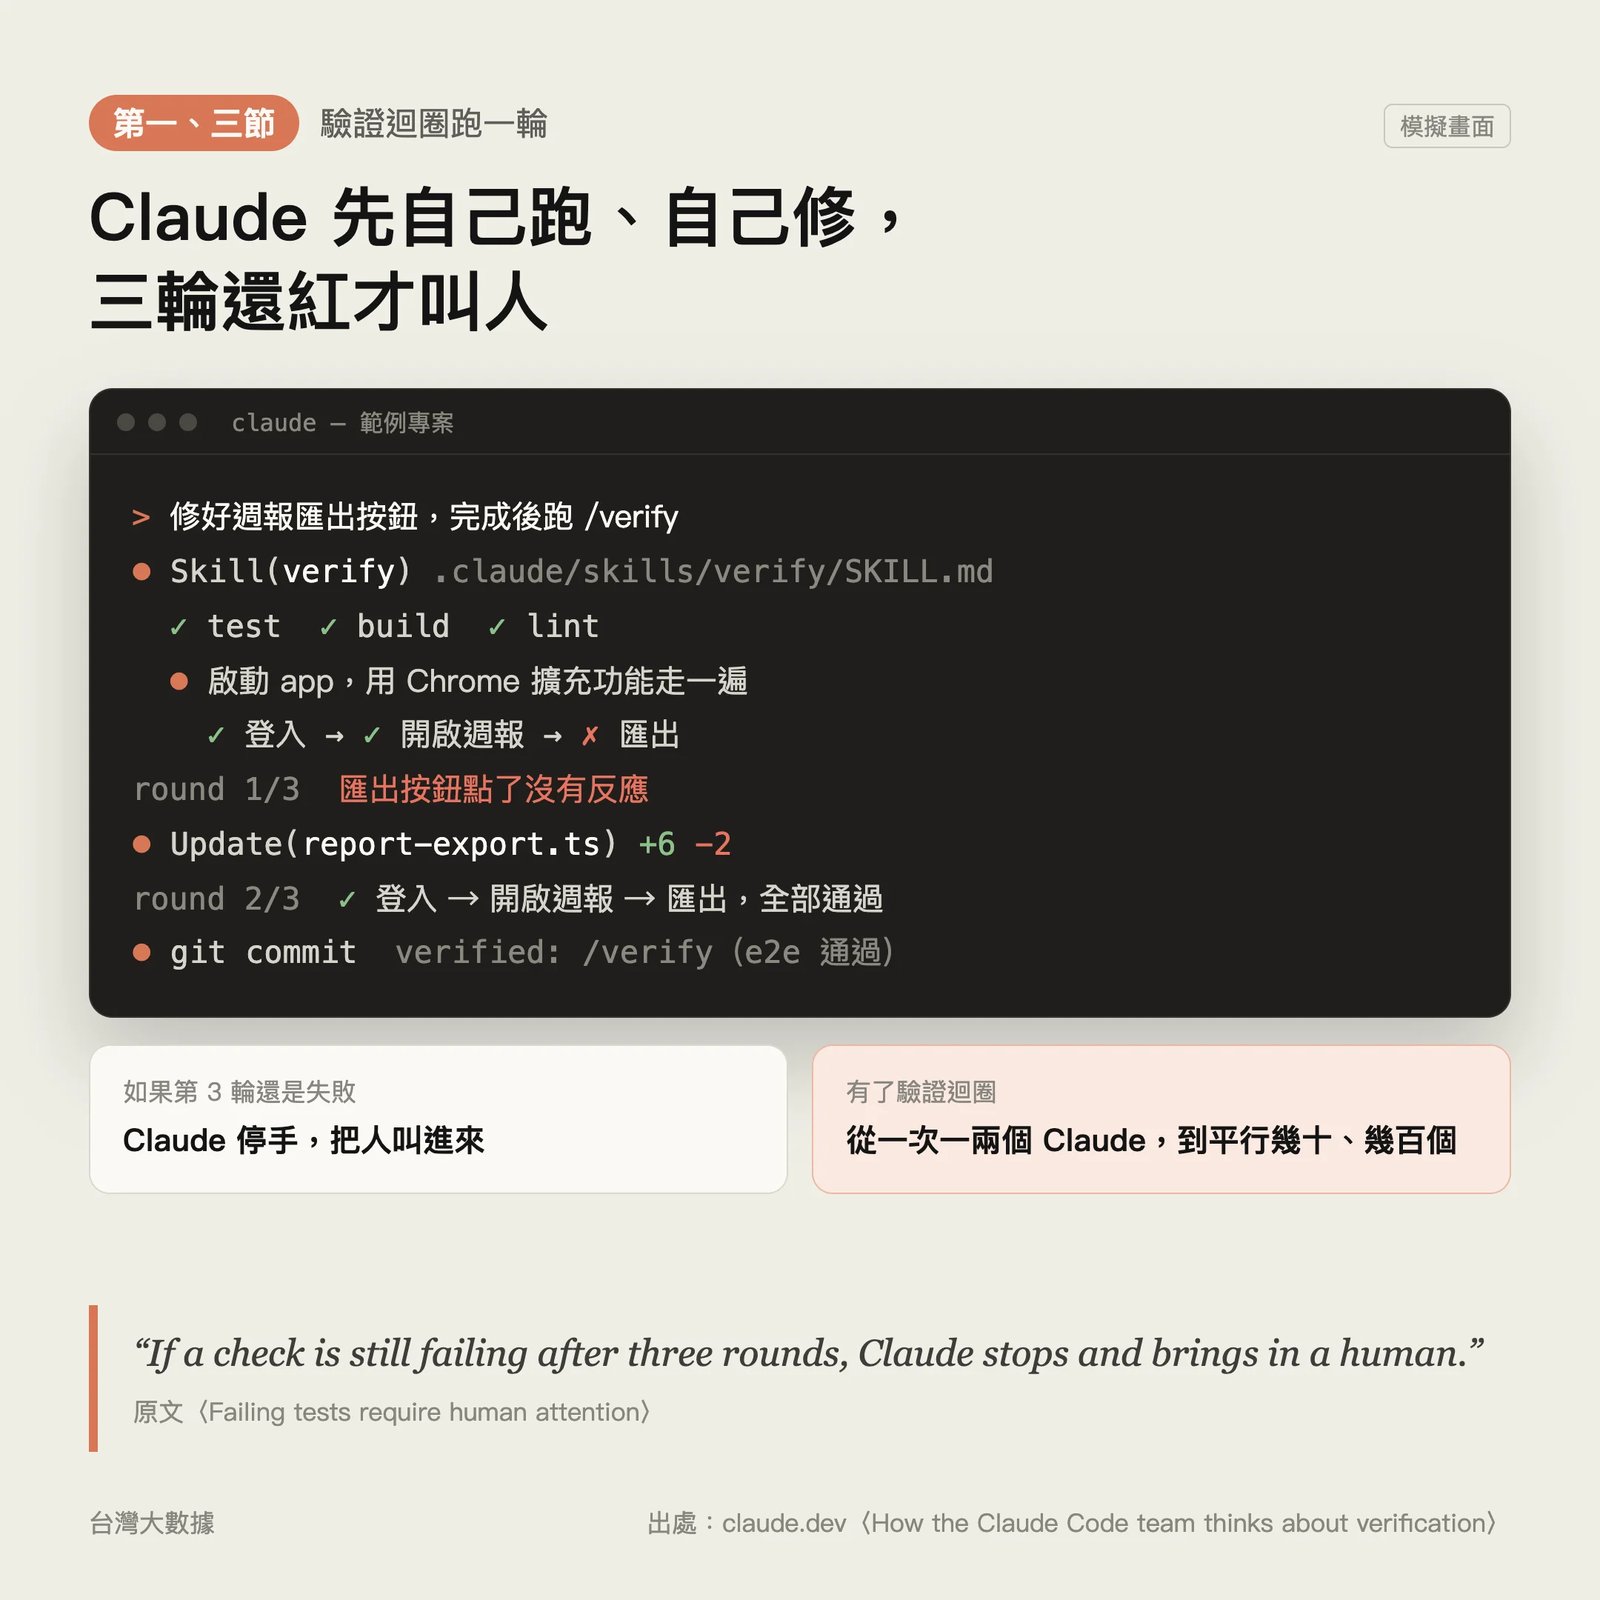
我們認為這一節最關鍵的設計是「三輪」這個停損點。它把人的注意力留給真正卡住的地方,agent 也不會在同一個錯上無限打轉。對要同時派出很多個 agent 的團隊來說,停損點要事先寫清楚,臨場判斷來不及。
四、改動不能碰評判它的規則
規則如果能被受審的改動修改,這道檢查就失效了。原文的做法是審查規則檔 REVIEW.md 一律從 base 或預設分支讀,從來不讀 pull request 裡改過的版本。
檢查也要跟著 diff 走。團隊維護一份 39 項的可靠性檢查清單,每項的觸發條件都能從 diff 看出來,Claude 讀完 diff 只跑命中的項目,通常 3 到 10 項,沒有人需要背過去的事故。每個 commit 都標註它是怎麼驗證的,沒驗證就記「none」,事後才查得到哪些改動沒被驗過。新的 commit 閘門有 off、observe、enforce 三種模式,observe 模式只記錄本來會擋下哪些 commit,讓團隊先檢查誤判;同一個 session 已被擋兩次,下一次就放行,免得 Claude 卡死。

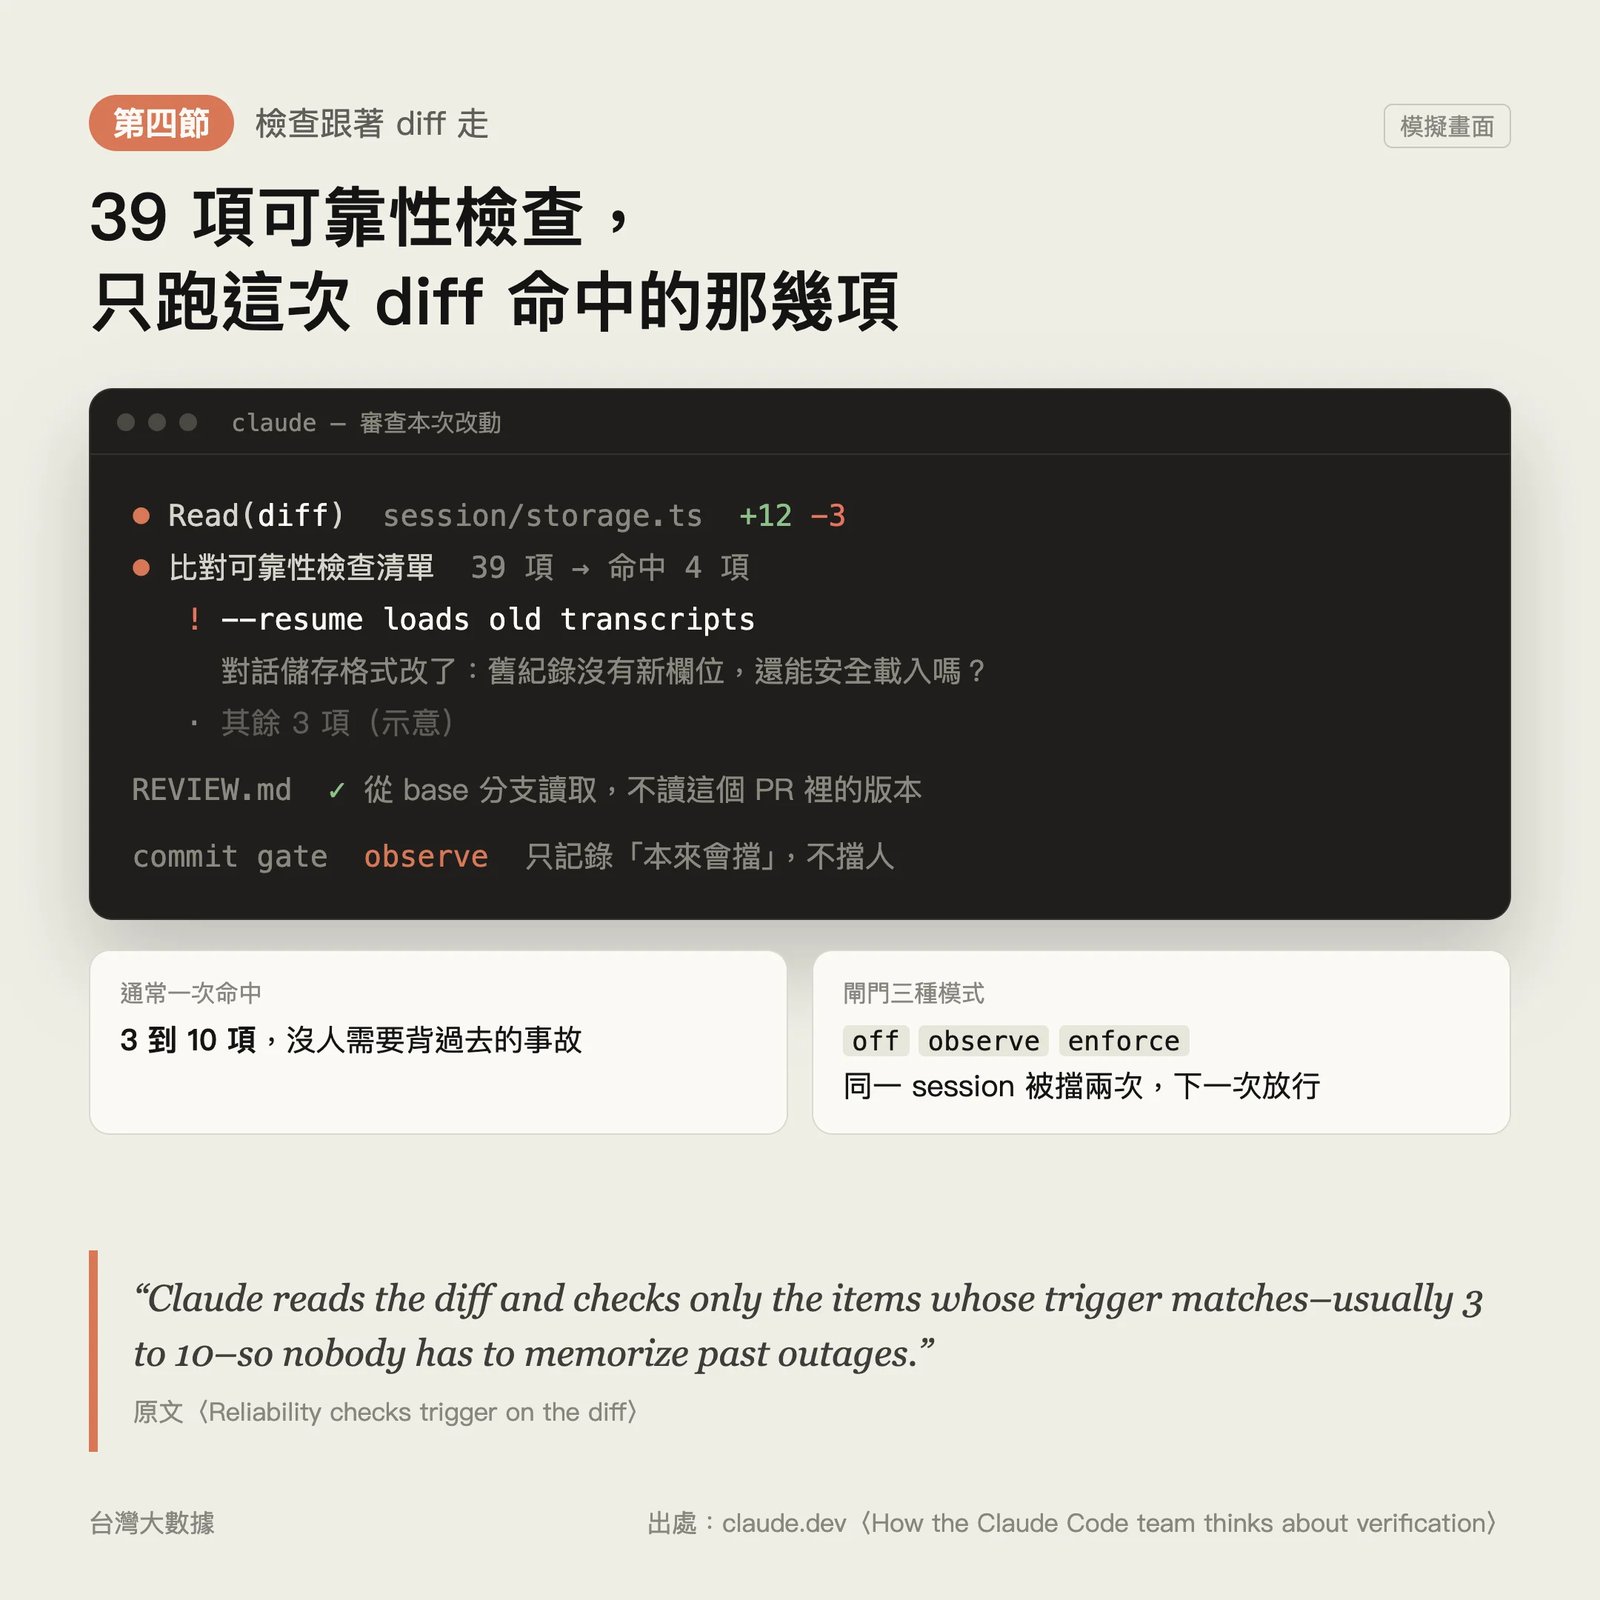
對我們來說,這一節最值得直接採用的是 observe 模式。新規則先觀察一段時間、確認誤判在可接受範圍,再開始擋,規則才不會一上線就把整條工作線卡住。
五、驗證者自己也要被驗、被修剪
驗證層會跟著時間老化,所以它本身也要被量測、被修剪。Claude Code 團隊定期追蹤合併後被 revert 的改動數、維護者在合併前退回的改動數,再拿一組大小相當、一直沒出事的改動當對照。
漏抓的案例要變成規則:同一種問題至少出現在兩個 PR、而且能從 diff 辨識,才列為候選,再由三個 agent 試著推翻,最後由人在 PR 裡審核核准。不穩定的測試不准跳過、加 sleep 或重試到過,找不到根因就刪掉並寫下原因。規則與測試也要定期清理,免得只增不減。
建議把這一節當成檢查清單:每條規則有沒有證據來源,有沒有對照組,多久清理一次。規則越堆越多,每次執行的成本終究會壓過它帶來的保護。
六、驗證層經營得好,工程師的工作就從讀 diff 轉向定義「完成」
原文的結論是把驗證層當成一套系統來經營:讓它碰不到被它評判的改動,用真正重要的 bug 替它打分,漏抓時寫下教訓,並定期修剪那些教訓。做到這些,工程師的工作會從逐行讀 diff,轉向定義「完成」長什麼樣子、再檢視證據,這也是能同時跑很多個 Claude 的前提。我們認為這個轉變適用於所有交給 AI 產出的工作,包括 GEO 的內容產出:先講清楚完成的標準,再要求拿出證據。
資料來源:Addy Osmani,〈How the Claude Code team thinks about verification〉,claude.dev Blog,2026 年 11 月 16 日。 https://claude.dev/blog/how-the-claude-code-team-thinks-about-verification/
